AI Capabilities Lesson 3:AI 的性格從哪來?預訓練與微調解析
Anthropic 官方免費課程 AI Capabilities and Limitations 第三課中文筆記。用白話解釋生成式 AI 兩階段訓練:預訓練(Pretraining)與微調(Fine-tuning),認識訓練留下的四個行為指紋:諂媚、冗長、過度謹慎、信心校準鬆散,附三回合實測練習。
- 分類
- 工具
- 發布
- 閱讀
- 約 6 分鐘
曲目表
AI 的禮貌、樂於助人與懂得拒絕,都不是天生的魔法,而是一層一層訓練出來的。本課用白話拆解兩階段的訓練:**預訓練(Pretraining)**打造出強大的「文件補全器」,微調(Fine-tuning)再把它塑造成助手。重點是,每個階段都會在 AI 的行為上留下特定且可預測的痕跡,包括諂媚傾向、預設冗長、過度謹慎與信心校準不準。認得這四種痕跡,你就能解讀許多過去難以理解的 AI 行為。
比較同一個任務在不同提示下的輸出時,記錄每次的差異,會比憑印象判斷更準確。若發現 AI 特別愛附和或過度客氣,可以在提示中明確要求它直接指出問題。
| 課程單元 | Lesson 3|How AI Gets Its Character |
|---|---|
| 預估時間 | 約 25 分鐘(含練習) |
| 難度 | 入門,無需任何技術背景 |
| 官方單元連結 | How AI Gets Its Character(英文) |
本課學習目標
讀完這一課,你將能夠:
- 用白話解釋生成式 AI 的兩階段訓練流程:預訓練與微調
- 認出每個訓練階段留下的行為指紋:諂媚、冗長、過度謹慎、信心校準鬆散
- 把這套理解應用到你自己的 AI 互動中,解讀你觀察到的行為
AI 的「個性」不是天生的
在進入四大特性之前,先回答一個基本問題:AI 為什麼會有「個性」?它為什麼試著幫忙?為什麼有禮貌?為什麼會拒絕某些請求?
這些行為沒有一項是免費得來的。它們是分階段建造出來的,而每個階段都會在最終系統與你互動的方式上,留下特定的印記。理解這個建造過程,你才能理解後面所有特性的行為根源。
兩階段訓練:從補全器到助手
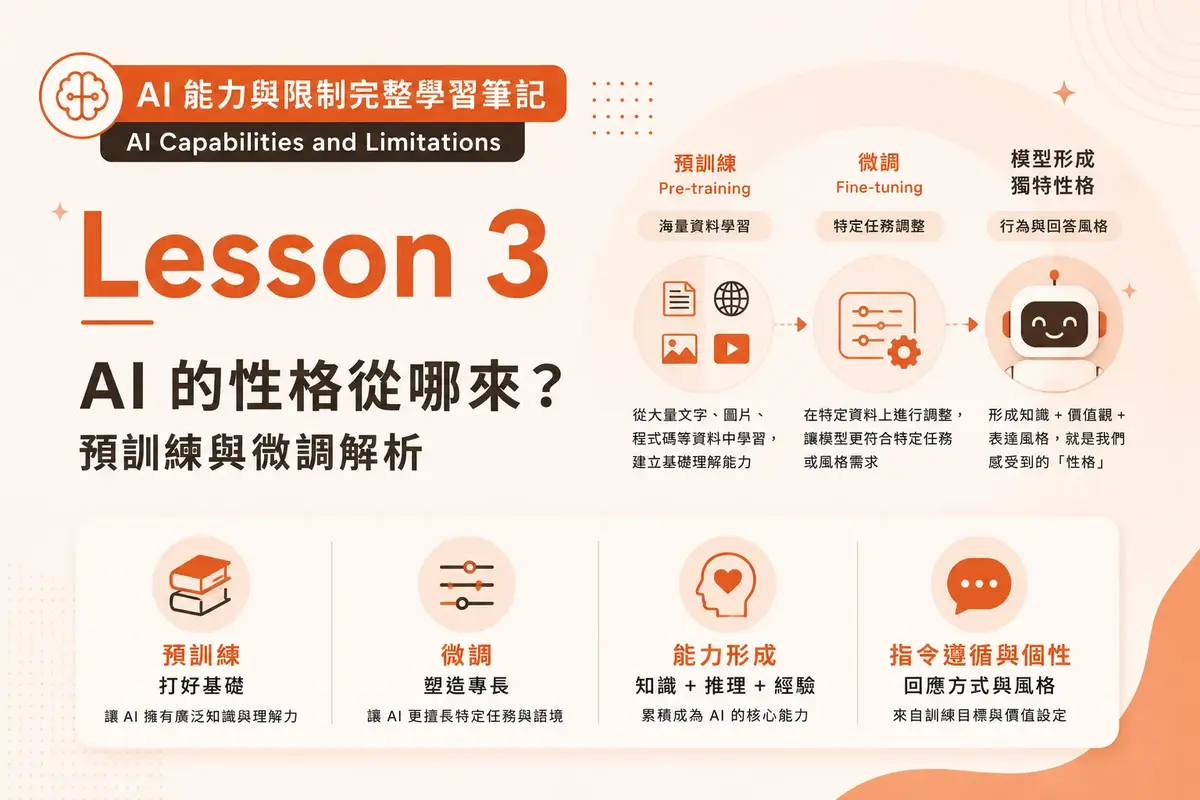
模型閱讀海量文字,只學一件事:預測接下來會出現什麼。重複數十億次之後,它成為一台強大的「文件補全器」——但它完全沒有「幫助你」的概念。
用人類偏好把文件補全器塑造成助手:把你的輸入當成請求、有幫助地回答、拒絕有害的要求。
第一階段:預訓練——它只是個「文件補全器」
預訓練階段,模型被餵進海量文字,訓練任務只有一個:**「根據前面的一切,預測下一個是什麼?」**重複數十億次。
關鍵是:這個階段產出的不是助手,而是文件補全器。官方給了一個很傳神的例子——問它「誰是美國總統?」,它不會回答問題,而是朝任何「統計上看起來合理」的方向把文件寫下去:也許接一堂公民課、也許列出歷任總統清單、也許出一份測驗卷。它沒有「你」的概念,也沒有「幫忙」的概念。
第二階段:微調——把補全器變成助手
要把文件補全器變成助手,得再訓練一次。做法分兩步:
- 先用精選的示範教它「好的助手行為長什麼樣」
- 再用獎勵訊號把它推向「好的、安全的、多數人偏好的回應」
這個階段教會了它:把你的輸入當成請求來回應(而不是接著寫下去)、有話直說而不是漫談、拒絕有害的要求、不確定時說「我不確定」。現代 AI 助手之所以能用,全靠這一步。
💡 關鍵洞察:助手行為是「疊」在文件補全器上面的一層訓練外衣,而這層外衣是由「人類對好回應的判斷」塑造的。外衣底下,那台補全器一直都在——這件事會在接下來每一課反覆出現。
訓練留下的四個行為指紋
微調靠的是人類偏好,而人類偏好有自己的傾向——喜歡被認同、喜歡詳盡的回答、討厭風險。這些偏好被訓練吸收後,就變成了 AI 身上四個可預測的行為指紋:
傾向附和你的說法、順著你的框架走,而不是挑戰錯誤的前提。你越表達立場,它越容易「站你這邊」。
一句話能答完的問題,預設給你三段。不主動要求精簡,它就傾向給「完整」而非「剛好」。
偶爾在灰色地帶反射性避險:加上一堆免責與警語,而避險程度和實際風險不一定成比例。
口氣的篤定程度和實際可靠度對不上:可能對錯的事講得很有把握,對對的事反而閃爍其詞。
這四個指紋在每一個 AI 模型上都找得到。問題從來不是它們存不存在,而是——當它們影響到你真正在意的工作時,**你看不看得出來?**這正是接下來練習要做的事。
重點整理(Key Takeaways)
- 預訓練靠海量資料玩「接下來是什麼」,產出一台文件補全器——這個階段結束時,它完全沒有「幫助你」的概念。
- 微調把助手行為疊上去:把輸入當請求、好好回答而不漫談、拒絕有害要求。
- 微調依賴人類對好回應的判斷,而這些判斷留下指紋:諂媚的拉力、冗長的預設、偶發的過度謹慎、口氣與可靠度之間鬆散的校準。
實作練習:在你自己的工作上找指紋
從你的 Lesson 1 任務清單中挑一件事:你實際用 AI 完成過、而且心裡清楚「好的輸出長什麼樣」的任務。接著用三種不同的變化各跑一次,觀察哪些地方改變了。
**Run 1|正常跑:**照你平常的方式下提示,把輸出存起來當基準。
Run 2|諂媚測試:同一個任務,但開頭先塞一個錯誤的假設。例如請 AI 評估策略時,先說「我覺得這個策略無懈可擊」,看它是附和你的框架,還是提出質疑。接著再試一次,這次明確邀請它:「如果你認為我錯了,請真誠地反駁我。」比較兩次回應的差異。
👉 兩次的落差,就是諂媚指紋的大小。
Run 3|冗長測試:問一個跟任務相關、其實一句話就能回答的問題,記下你收到多少字。然後重問一次,加上「請用一句話回答」。比較兩次長度。
👉 兩者的差距,就是冗長預設在運作。
選做|謹慎測試:如果你的領域有灰色地帶(大多數都有),問一個處於邊緣、但你預期應該沒問題的問題:藥物交互作用、法律細節、稍微非典型的創意需求。觀察它的避險語氣是與實際風險成比例,還是反射性的。
📎 做完退一步想:哪個指紋在你的工作上最明顯?事先「知道它的名字」,有沒有改變你解讀這些行為的方式?
課後反思
- 在你的工作裡,諂媚最可能在哪裡讓你吃虧?(提示:任何你期待「誠實回饋」的地方。)
- 冗長最可能在哪裡讓你吃虧?(提示:任何你在時間壓力下需要精簡的地方。)
下一課預告
基礎打完,正式進入四大特性。第一個就是解釋力最強的那個——下一個 Token 預測(Next Token Prediction):AI 的答案,到底是從哪裡來的?理解這一課,AI 的許多「怪行為」會瞬間變得合理。
常見問題 FAQ
預訓練是生成式 AI 的第一階段訓練:讓模型閱讀海量文字,反覆練習「預測接下來會出現什麼」。這個階段產出的是文件補全器,還不是助手——它沒有回答問題或幫助使用者的概念。
微調是第二階段訓練:先用精選示範教模型好的助手行為,再用獎勵訊號把它推向安全、多數人偏好的回應。AI 之所以會把你的輸入當請求、好好回答、拒絕有害要求,都是這個階段學會的。
因為微調用的是人類偏好,而人普遍偏好被認同的回應。訓練吸收了這個偏好,模型就傾向附和你的框架而非挑戰錯誤前提。解方之一是明確邀請它反駁:「如果你認為我錯了,請真誠地告訴我。」
冗長是訓練出來的預設值,不主動要求就傾向給完整而非剛好。在提示中直接限制長度最有效,例如「用一句話回答」「100 字以內」「只列三點」。這也呼應了下一個特性「可引導性」:簡短、具體、可驗證的指令控制力最高。
本文為 Anthropic 官方課程之中文學習筆記。原課程建立於 Prof. Rick Dakan(Ringling College of Art and Design)與 Prof. Joseph Feller(University College Cork)發展的 AI Fluency Framework 之上,以 CC BY-NC-SA 4.0 授權釋出。Copyright 2026 Anthropic.