AI Capabilities Lesson 2:什麼是生成式 AI?和你每天用的 AI 差在哪
Anthropic 官方免費課程 AI Capabilities and Limitations 第二課中文筆記。分辨生成式 AI 與分類型 AI 的本質差異,認識能力—限制連續光譜,一次看懂四大特性:Next Token Prediction、知識、工作記憶、可引導性的能力區與限制區,附實作練習。
- 分類
- 工具
- 發布
- 閱讀
- 約 5 分鐘
曲目表
你身邊絕大多數的 AI,例如垃圾郵件過濾、影片推薦與盜刷偵測,其實都不是生成式 AI。本課先釐清這門課所說的「AI」指的是什麼:會產生新內容的 Transformer 文字模型。接著建立全課程最重要的觀念,也就是能力與限制的連續光譜:AI 的強項與弱點來自同一個機制,你的任務落在光譜的哪個位置,決定你感受到的是能力還是限制。文末會先預覽四大特性各自的能力區與限制區。
分辨某個功能是不是生成式 AI,可以看它是否會產生新的文字、圖片或程式碼。判斷時把它當成工具來看,就能更清楚它適合與不適合的任務。
| 課程單元 | Lesson 2|What We Mean by AI |
|---|---|
| 預估時間 | 約 20 分鐘(含練習) |
| 難度 | 入門,無需任何技術背景 |
| 官方單元連結 | What We Mean by AI(英文) |
本課學習目標
讀完這一課,你將能夠:
- 分辨生成式 AI 與你每天接觸的分類/預測型 AI 有什麼本質不同
- 理解生成式 AI 的特性存在於一條從能力到限制的連續光譜上
- 預覽四大核心特性:下一個 Token 預測、知識、工作記憶、可引導性
你身邊大多數的 AI,其實不是生成式 AI
「AI」這個詞的範圍太廣了,開始之前得先畫清界線。想想你今天已經遇過哪些 AI:
- 幫你挑下一部影片的推薦引擎
- 信箱裡的垃圾郵件過濾器
- 標記可疑刷卡交易的盜刷偵測模型
- 把你的客服來電轉接到正確窗口的路由系統
這些全都是 AI,但它們什麼都沒有「生成」。它們做的是分類、排序、預測——處理已經存在的內容。這類系統極其有用、極其普遍,但不是這門課的主角。
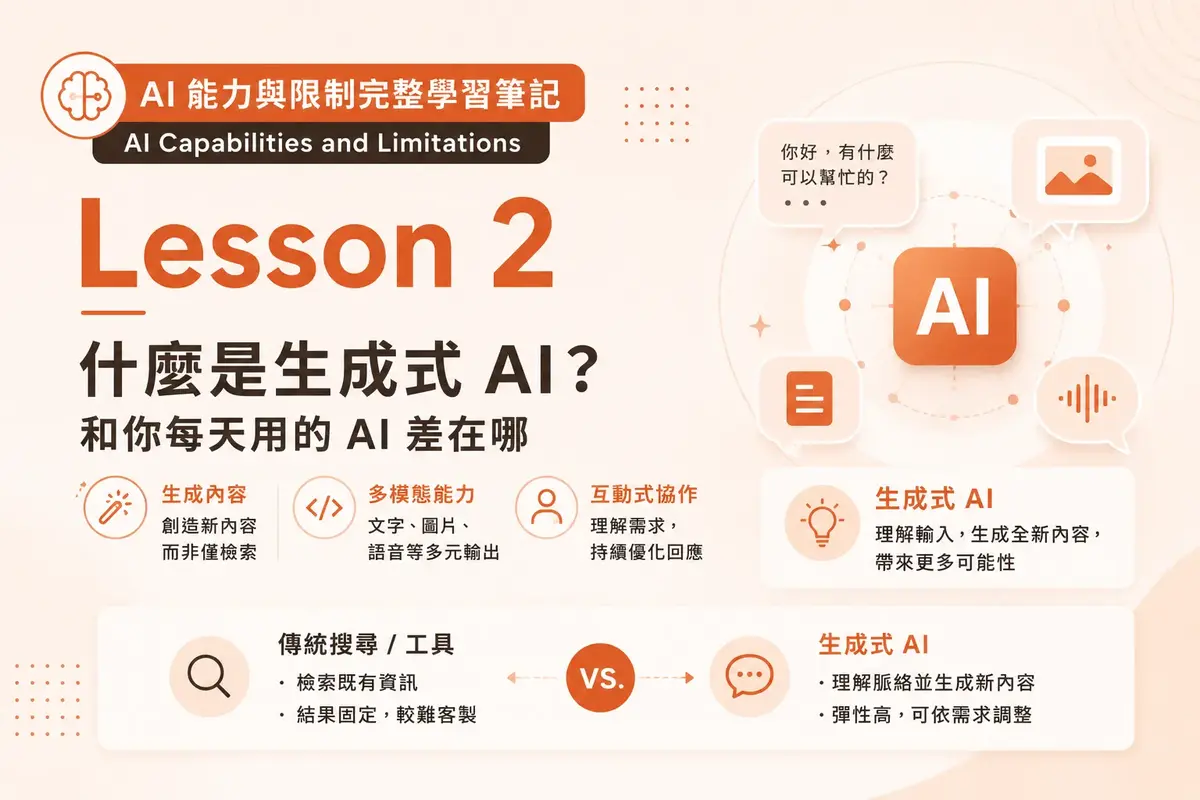
近年真正改變局面的是生成式 AI(Generative AI)的崛起:不是替既有內容分門別類,而是產生全新的內容——文字、圖片、程式碼、音訊、影片。從這裡開始,整門課說的「AI」,指的都是生成式 AI。
對既有內容做分類、排序、預測。
例:垃圾郵件過濾、影片推薦、盜刷偵測、人臉標記。
產生全新的內容。
例:Claude、ChatGPT 等聊天助手、圖片生成、程式碼生成。這門課講的是這種。
生成式 AI 裡面,也還有分別
即使同屬生成式 AI,底層技術也不一樣。圖片生成通常用擴散模型(diffusion model):從一片雜訊開始,一步步「雕」出一張圖。而文字生成——你正在對話的那種——用的是 Transformer:一次一個 token,預測接下來該出現什麼。(另外還有 GAN、VAE 與各種混合架構。)
這門課的四大特性,描述的正是 Transformer 文字模型——也就是你用聊天機器人、寫作助手時面對的那種 AI。其中不少概念也能轉移到其他生成式 AI 上,但核心對象是文字模型。
核心觀念:能力—限制連續光譜
上一課提過這門課的中心思想,這裡正式展開:AI 不是全能,也不是全不可靠,它的強與弱分布在四條特定且可預測的軸線上。而且每條軸線都是連續光譜——同一個機制,既給你能力,也給你限制。你的任務越往光譜右側移動,就越需要查證與補位。
任務落在這裡:放心委派
任務飄到這裡:加強查證
以下是四大特性的完整預覽。每項特性都用一個「核心問題」來記,之後 L4–L11 會逐一深入:
💡 **校準信任(calibrated trust):**聰明的 AI 使用者不是「全盤相信」或「全盤不信」,而是先定位任務在光譜上的位置,再決定該給多少信任、做多少查證。這就是這張表的用法。
重點整理(Key Takeaways)
- 生成式 AI 產生新內容,而不是替既有內容分類。
- AI 不是全能也不是全不可靠,它沿著四條可預測的軸線有強有弱:下一個 Token 預測、知識、工作記憶、可引導性。
- 每項特性都是連續光譜,同一個機制同時給你能力與限制。
- 校準信任的意思是:定位你的任務在光譜上的位置,而不是全盤給予或全盤收回信任。
實作練習:生成式,還是分類式?
你剛學會了生成式 AI 與分類型 AI 的根本差異,現在把這個區分用在自己的生活經驗上。
**步驟一:**列出你這週接觸過的 5 個 AI 功能,範圍可以放寬一點,例如輸入法自動完成、照片人臉標記、垃圾郵件過濾、聊天機器人回答、翻譯、商品推薦與語音助理等。
步驟二:逐一判斷:它是在產生新內容,還是在分類、排序既有內容?寫下你的答案。
**步驟三:**把清單丟給 AI 請它批改。答錯或不確定的項目,請它用一句話解釋差別在哪。然後再問一句:「這 5 個裡面,哪一個最可能有這門課會幫我理解的失誤模式?」
**步驟四:**回到你在 Lesson 1 做的任務清單,替每項任務貼上一個你直覺認為最相關的「特性問題」標籤:
- 🎲 答案是從哪裡來的?(下一個 Token 預測)
- 📚 它知道這件事嗎?(知識)
- 🧠 它現在注意著什麼?(工作記憶)
- 🧭 我有多少控制權?(可引導性)
📎 貼錯沒關係!這一步不是要你答對,而是建立「預測」——接下來四個特性的課程,就是拿來檢驗這些預測的。
課後反思
- 「生成式 vs 分類式」的區分,有沒有改變你對某個常用工具的看法?
- 回看你貼的標籤:有沒有哪個任務感覺同時屬於不只一個特性?(記住這個感覺,L12「當特性互相衝突」會正面處理它。)
下一課預告
正式進入四大特性之前,還有一個必答題:AI 為什麼會有「個性」?它為什麼有禮貌、樂於助人、會拒絕某些要求、有時又太容易附和你?下一課拆解預訓練與微調如何一步步塑造 AI 的性格——這個塑造過程,會在後面所有特性上留下指紋。
常見問題 FAQ
算,而且是目前世界上運作中最普遍的 AI。但它們屬於分類/預測型 AI,做的是對既有內容分類、排序與預測,不會產生新內容,因此不在這門課的討論範圍。
Claude 和 ChatGPT 都是生成式 AI 中「基於 Transformer 的文字模型」的產品實例:以一次一個 token 的方式產生文字。這門課的四大特性描述的正是這類模型的共通性質。
部分適用。圖片生成多半使用擴散模型,與文字模型的 Transformer 架構不同;本課的四大特性是針對文字模型設計的,其中不少觀念(如訓練資料決定知識範圍)可以轉移,但不是一對一適用。
指不對 AI 全盤相信、也不全盤否定,而是根據任務落在能力—限制光譜上的位置,動態決定要給多少信任、做多少查證。這是整門課要培養的核心能力。
本文為 Anthropic 官方課程之中文學習筆記。原課程建立於 Prof. Rick Dakan(Ringling College of Art and Design)與 Prof. Joseph Feller(University College Cork)發展的 AI Fluency Framework 之上,以 CC BY-NC-SA 4.0 授權釋出。Copyright 2026 Anthropic.